Böcker
LSSx.0-metoden i tre volymer – den teoretiska grunden bakom den standard som våra certifieringar bygger på.
LSSx.0 – Flow Problems and Lean Management
Youri Buffe
2026 | Lean Six Sigma International Editions
Denna första volym lär ut grunderna i flödesproblemlösning och de grundläggande principerna för Lean Management. Boken vänder sig till studenter och instruktörer inom Lean Six Sigma, samt chefer som vill gå längre än att bara lära sig formler och utveckla sina arbetssätt utifrån en solid teoretisk grund. Med respekt för de historiska rötterna, andan och den etablerade terminologin inom Lean Six Sigma strävar boken efter att identifiera, förena och formalisera dess underliggande grundprinciper.
Köp boken
LSSx.0 – Methodological Foundation and Discernible Problems
Youri Buffe
2026 | Lean Six Sigma International Editions
Denna andra volym detaljerar implementeringen av arbetssättet i företag och det generiska metodiska DMAIC-protokollet. Baserat på en originell definition av statistiska problem lär den ut grunderna för att lösa "skönjbara" statistiska problem samt grundprinciperna för Six Sigma. Boken vänder sig till studenter och lärare inom Lean Six Sigma, samt yrkesverksamma inom operational improvement som vill gå längre än att bara lära sig formler och utveckla sina arbetssätt utifrån ett solid teoretiskt ramverk.
Köp boken
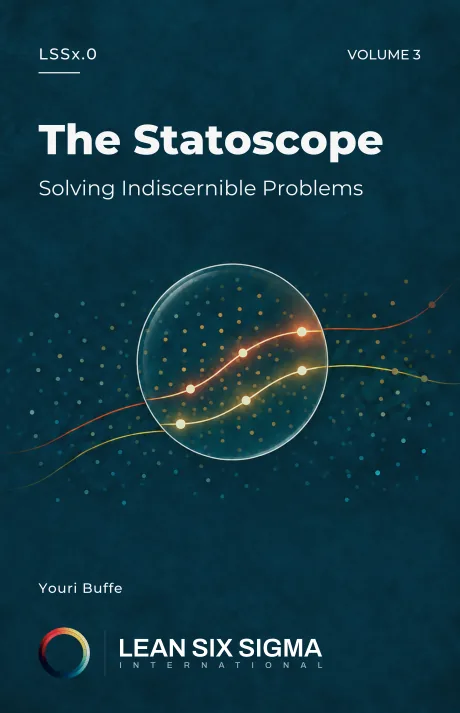
LSSx.0 – The Statoscope: Solving Indiscernible Problems
Youri Buffe
2026 | Lean Six Sigma International Editions
Denna tredje volym visar hur du analyserar och minskar problem vars orsaker förblir otydliga i enskilda fall. Med utgångspunkt i en originell analogi med optik förklaras hur analytiska resurser kalibreras i förhållande till den förbättring som eftersträvas. Den visar hur hypotesprövning används för att identifiera användbara förbättringsatgärder, utvärdera realistiskt uppnåeliga vinster och avgöra om föreslagna lösningar kan nå målet. Boken vänder sig till utövare av Six Sigma och användare av statistisk analys som vill utnyttja beslutspotentialen i små datamängder till fullo.
Köp boken
Artiklar
Revideringsförslag av definitionen av antalet skilda kategorier och acceptanskriterier för validering av mätsystem
Författare: Youri Buffe
September 23, 2022
Sammanfattning:
%GRR och antalet skilda kategorier (NDC) används i stor utsträckning som kapabilitetsindikatorer för mätsystem. Den vanligtvis accepterade beräkningsformeln för NDC har dock tilldelats en koefficient vars ursprung har lett till att två olika och missvisande tolkningar av NDC uppstått parallellt. Vi rekommenderar att ta bort denna koefficient för att hålla oss till mätsystemets upplösningsdefinition eller motsvarande signal-till-brus-koncept. Vi föreslår även en omjustering av acceptansgränserna för %GRR och NDC.
Full åtkomst
Bestämning av urvalsstorlek för uppskattning av felandel i processer vid räkning av defekter
Författare: Youri Buffe
Maj 3, 2022
Sammanfattning:
Som en del av Mätfasen i ett Six Sigma-projekt (DMAIC) är det avgörande att bestämma en lämplig urvalsstorlek utifrån den statistiska precision som krävs för att uppskatta processkapabiliteten (här definierad som den förväntade andelen defekta enheter). Six Sigma-utövare får vanligtvis lära sig att använda antingen tumregler (vilket förbigår precisionskravet) eller en formel för urvalsstorlek som gör det möjligt att specificera den precision som krävs. Även om en sådan formel finns tillgänglig för binära data, handlar den vanliga formeln som lärs ut vid hantering av defekträkning om att uppskatta det genomsnittliga antalet defekter per enhet och inte andelen defekta enheter (dvs. felandelen). Denna artikel utarbetar en formel och härledda tabeller för att beräkna den urvalsstorlek som krävs för att uppnå den nödvändiga statistiska precisionen för felandelen vid arbete med en mätstorhet baserad på defekträkning. Omvänt beräknas den erhållna precisionen för en given urvalsstorlek. Resultaten jämförs sedan med de för binära data, och det föreslås att beräkningen av urvalsstorlek för binära data är värd att övervägas som ett acceptabelt och enklare alternativ. Utmaningen att uppnå godtagbar precision på grund av kraven på urvalsstorlek vid låga felandelar belyses också.
Full åtkomst
Bestämning av urvalsstorlek för uppskattning av felandel i processer vid kontinuerliga mätdata
Författare: Youri Buffe
Mars 28, 2022
Sammanfattning:
Som en del av Mätfasen i ett Six Sigma-projekt (DMAIC) är det avgörande att bestämma en lämplig urvalsstorlek utifrån den statistiska precision som krävs för att uppskatta processkapabiliteten (här definierad som den förväntade andelen defekta enheter). Six Sigma-utövare får vanligtvis lära sig att använda antingen tumregler (vilket förbigår precisionskravet) eller en formel för urvalsstorlek som gör det möjligt att specificera den precision som krävs. Även om en sådan formel finns tillgänglig för binära data, handlar den vanliga formeln som lärs ut vid hantering av kontinuerliga data om att uppskatta medelvärdet och inte felandelen. Andra alternativa tillvägagångssätt handlar om att beräkna urvalsstorleken baserat på precision i processkapabilitetsindex utformade för tillverkningsindustrin. Dessa tekniska index är dock ofta inte relevanta för de flesta användare och chefer som inte arbetar i specifika produktionsmiljöer. Denna artikel utarbetar lösningar för att beräkna den urvalsstorlek som krävs för att uppnå den nödvändiga statistiska precisionen för felandelen vid arbete med kontinuerliga mätdata, både vid en och två specifikationsgränser. Omvänt beräknas den erhållna precisionen för en given urvalsstorlek. Utmaningen att utvärdera höga prestandanivåer för Sigma på grund av den urvalsstorlek som krävs belyses också.
Full åtkomst


